Fra ABBYY til Gemini: Slik bygget vi om kvitteringsgjenkjenningen med KI
De siste 6+ årene har jeg bygget og videreutviklet produktet Nettlønn fra ECIT, som lar ansatte rapportere utlegg via en mobilapp – og hjelper virksomheter med å gå gjennom, godkjenne og håndtere disse rapportene effektivt.
av Yaroslav Nychka, programvareutvikler | Ruby-utvikler i Innocode
De siste 6+ årene har jeg bygget og videreutviklet produktet Nettlønn fra ECIT, som lar ansatte rapportere utlegg via en mobilapp – og hjelper virksomheter med å gå gjennom, godkjenne og håndtere disse rapportene effektivt.
En ansatt kan ta bilde av en kvittering på restauranten eller parkeringsplassen, rett i appen. Ingen grunn til å samle papirlapper eller skrive ut PDF-er. Digitale kvitteringer – som flybestillinger eller fakturaer fra Uber – kan ganske enkelt videresendes på e-post og behandles automatisk.
Når en kvittering er registrert, analyserer backend den og forhåndsutfyller nøkkelfelt som beløp, valuta, brukersted og dato. De ansatte trenger ikke lenger å skrive inn alt manuelt – de bare kontrollerer og sender inn.
På den andre siden kan regnskapsførere og ledere bruke et nettbasert backoffice eller en mobilapp til å gå gjennom, godkjenne eller avvise utlegg med noen få trykk.
Den ideelle flyten er enkel: ta bilde og send. Ingen manuell skriving, ingen skjemautfylling – bare en rask kontroll. Det er det vi har siktet mot fra første dag.
Men i kjernen av det hele ligger den vanskeligste – og viktigste – utfordringen: å forstå kvitteringer.
Det handler ikke bare om å gjenkjenne tekst. Det handler om å hente ut riktig totalbeløp, korrekt mva og det faktiske navnet på brukerstedet – pålitelig, på tvers av alle dokumentformater, språk og oppsett. Disse dataene går rett til økonomiavdelingen og påvirker refusjoner, regeletterlevelse og interne revisjoner.
Hvis noe er feil – selv bare litt – kan et utlegg bli avvist. Det er frustrerende for den ansatte som gjorde alt riktig. Og la oss innse det: under press gjør også økonomiavdelinger feil. Å få dette riktig er ikke valgfritt – det er avgjørende.
Og det er her vi tok vårt største sprang: fra skjøre regex-regler og aldrende OCR-motorer … til ekte KI som forstår dokumenter som et menneske.
Et arvet system du ikke kan røre: låst til ABBYY og en jungel av uhåndterlige regex-regler
Da jeg kom inn i prosjektet i 2019, hadde plattformen allerede brukt ABBYY Cloud OCR i flere år – og for å være tydelig: ABBYY var ikke problemet.
OCR-motoren fungerte ganske bra. Den kunne hente ut rå tekst og strukturerte data fra skannede kvitteringer, fakturaer og PDF-er. De fleste dokumenter ble behandlet på under ett minutt, selv om noen tok opptil to – og store PDF-er kunne feile eller få tidsavbrudd.
Men alt i alt gjorde den jobben sin. Det egentlige problemet var det som var bygget rundt den.
For å få nyttige data ut av ett enkelt bilde måtte systemet:
- Sende bildet til ABBYY for gjenkjenning av rå tekst.
- Deretter gjøre et nytt API-kall for å hente ABBYYs strukturerte XML.
Dette var ikke bare ineffektivt – det doblet kostnaden, ga økt ventetid og flere mulige feilpunkter. Noen ganger lyktes den første forespørselen mens den andre feilet, noe som ga ufullstendig behandling eller feil ingen la merke til.
Enda verre: systemet videre i kjeden – dusinvis av regex-regler og egne parsere – var ikke bare avhengig av ABBYYs data, men av den nøyaktige strukturen i den gamle XML-en.
Det jeg arvet, var et system der:
Regex-logikken var tett koblet til ABBYYs XML.
- Parselogikken var duplisert, inkonsistent og udokumentert.
- Det fantes ingen abstraksjon mellom OCR og forretningslogikk.
- Ingen forsto egentlig hvordan endringer ville påvirke resten av løpet.
Det ble tydelig hvorfor tidligere forsøk på å oppgradere til nyere ABBYY-API-er hadde mislyktes. Selv små forskjeller i XML-strukturen ødela hele kjeden. Jeg prøvde å fjerne den andre forespørselen – for å redusere kostnader og forenkle flyten – men hele kjeden var for skjør. En utvikler før meg hadde også prøvd – og sluttet kort tid etter.
Vi brukte ikke bare ABBYY – vi var helt avhengige av særegenhetene dens.
Og det hadde en pris.
Over tid gjorde denne arkitekturen mer enn å bremse oss – den tæret stille på motivasjonen:
- Utviklerne ble redde for å røre OCR-logikken.
- Å rette én feil ødela ofte noe annet.
- Feil skjedde i det stille – kvitteringer ble ikke behandlet, og ingen kunne forklare hvorfor.
- Kundenes tillit sank.
- Teamet krympet. Til slutt ble produktet solgt til et nytt selskap.
I ettertid var varselsignalene overalt.
Regex-laget var blitt kjernen i produktet – men det var skjørt, udokumentert og risikabelt å videreutvikle. Systemet motsatte seg ikke bare endringer – det straffet forsøk på forbedring.
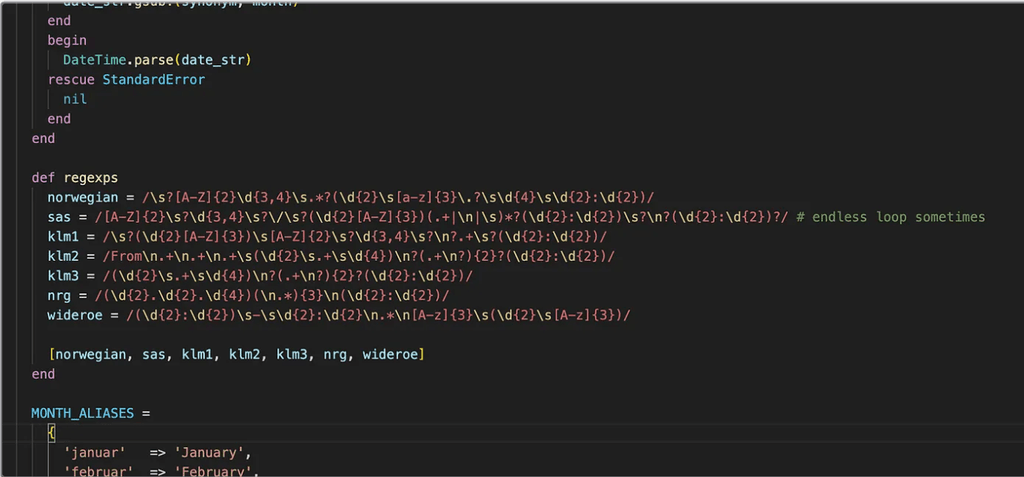
Viktig å merke seg: ABBYY OCR og regex er ikke dårlige i seg selv.
Vi bruker fortsatt regex i dag – for eksempel til å gjenkjenne filtyper i videresendte e-poster før de rutes til KI-løpene.
Problemet var ikke verktøyene. Det var den skjøre arkitekturen som limte dem sammen.
Det fantes ingen skille mellom OCR-resultatet og forretningslogikken. Parsereglene var hardkodet til ABBYYs XML-format – uten reserveløsning og uten plan for videreutvikling.
Til slutt var vi ikke bare avhengige av ABBYY – vi var låst til en utdatert versjon og kunne ikke oppgradere uten å risikere feil i dusinvis av skjøre parseregler.
Det som startet som en smart snarvei, var blitt en risikofylt flaskehals som frustrerte utviklerne, forvirret brukerne og hindret fremgang.
Da visste vi det: Det var på tide å finne en bedre løsning.
I stedet for å rive ut alt over natten valgte vi en gradvis tilnærming – og det var her Google Document AI kom inn.
Parallelt med utviklingen av backend skrev vi hele den opprinnelige Travis-appen på nytt fra bunnen av – den var dårlig integrert med backend. Den nye appen er skrevet i Dart/Flutter og henger mye bedre sammen. Samtidig utviklet vi et nytt API som er konsistent på tvers av web og mobil. Det betydde å omorganisere arkitekturen: ett felles backend-API som betjener begge plattformene sømløst. Når jeg ser tilbake, har det skjedd utrolig mye i løpet av de fem årene jeg har vært med på dette – på alle fronter, fra brukergrensesnitt til infrastruktur.
Å bryte seg løs: et adapterlag
Før vi i det hele tatt kunne tenke på å erstatte ABBYY, måtte vi vikle oss løs.
Det gamle systemet var tett koblet til ABBYY – regex-regler, parsere og forretningslogikken videre i kjeden var alle avhengige av den nøyaktige strukturen. Å bytte OCR-motor uten forberedelser ville ha ødelagt hele løpet.
For å gjøre endring mulig innførte jeg et adapterlag – som pakket inn all kommunikasjon med ABBYY bak ett felles inn-/ut-grensesnitt. Det ga oss et tydelig skille mellom OCR-motoren og resten av systemet – for første gang kunne vi bytte motor uten å skrive om alt annet.
Med denne abstraksjonen på plass implementerte jeg en adapter for Google Document AI med det samme grensesnittet – slik at ABBYY og Document AI kunne byttes inn og ut sømløst.
Hvorfor Google Document AI?
Vi valgte Google Document AI av tre hovedgrunner:
- Passet med infrastrukturen – selv om kundenes kvitteringer var lagret i AWS, kjørte resten av plattformen på Google Cloud, noe som gjorde integrasjon og utrulling enklere.
- Forhåndstrent intelligens – Document AI tilbød ferdige prosessorer for kvitteringer og fakturaer, noe som ga oss et godt utgangspunkt.
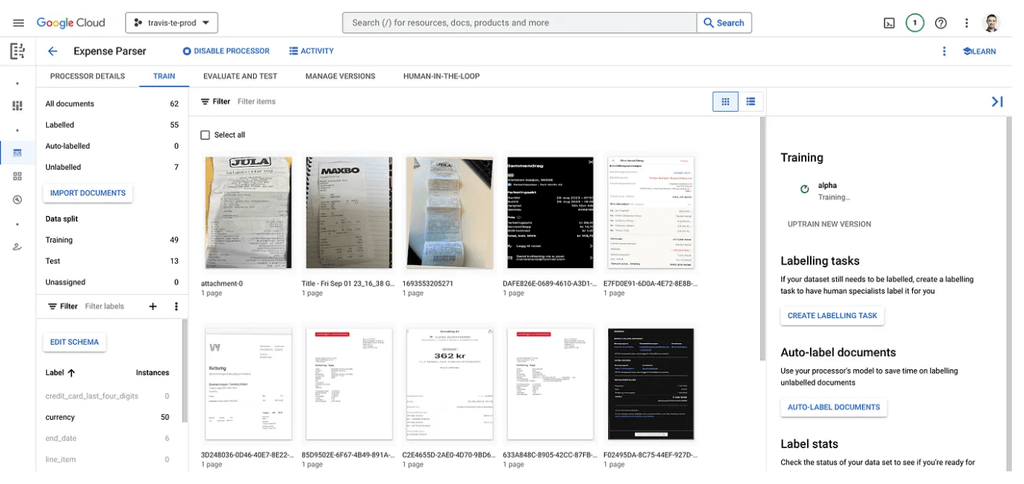
- Sikker, kontrollert trening – en viktig faktor var muligheten til å trene modeller uten å sende sensitive dokumenter til ukjente tredjepartstjenester. Med Google Document AI kunne vi laste opp ekte kvitteringer, merke dem selv i grensesnittet og holde alt innenfor et skyøkosystem vi stolte på.
Men den største fordelen var egne prosessorer.
Vi kunne trene Document AI på ekte kvitteringer ved å merke nøkkelfeltene manuelt i treningsgrensesnittet. Ja, det tok tid, og ja, det krevde et menneske i løkka. Men det fungerte. Over tid ble nøyaktigheten bedre – og vi fikk en kontroll vi aldri hadde hatt med ABBYY.
Parallelle løp og sammenligning i sanntid
På dette tidspunktet hadde vi to OCR-motorer som kjørte bak det samme grensesnittet.
Men å bytte motor i blinde var ikke et alternativ. For å unngå tilbakefall og gå trygt over til Document AI bygget jeg en parallell kjøring: Hvert dokument som ble behandlet av ABBYY, ble også sendt i det stille til Document AI.
Vi logget begge resultatene og sammenlignet dem – og målte nøyaktigheten felt for felt.
Denne fasen var avgjørende. Den ga oss trygghet til å bytte når tiden var inne – i visshet om at vi ikke satte ekte kundedata i fare eller svekket kvaliteten.
Måling av nøyaktighet: felt for felt, kvittering for kvittering
For å gå lenger enn logger og diffs bygget jeg et internt grensesnitt som viste hver kvittering side om side – én tolket av ABBYY, den andre av Google Document AI.
Dette var ikke bare for syns skyld. Det lot administrasjonsteamet vårt merke de riktige verdiene felt for felt manuelt, noe som hjalp oss å svare på et avgjørende spørsmål: Hvilken motor traff faktisk riktig?
Med denne tilbakemeldingssløyfen på plass bygget jeg et dashbord som fulgte nøyaktigheten for begge motorene. Nå kunne vi se – i sanntid – hvordan ABBYY og Document AI presterte på nøkkelfelt som brukersted, totalbeløp, valuta og dato.
Målet vårt var enkelt: Document AI måtte være like god som ABBYY – eller litt bedre – før vi i det hele tatt ville vurdere å bytte.
For å teste dette kjørte vi dusinvis av ekte kvitteringer gjennom løpet og lot teamet merke fasitdata. For hvert dokument beregnet systemet gjenkjenningsnøyaktigheten for begge leverandørene. Det ga oss noe sterkere enn magefølelse: en statistisk meningsfull kvalitetsscore basert på ekte data.
Det tok et par uker med merking og iterasjon. Men investeringen lønte seg – ikke bare i nøyaktighet, men i trygghet.
Da evalueringen var ferdig, diskuterte vi ikke lenger meninger. Vi hadde grafer, poengsummer og dokumenterte forbedringer. Det var ikke bare slik at Document AI føltes bedre – vi visste at den var det.
Trygg utrulling og slutten for ABBYY
Å gå live betydde ikke å trykke på én global bryter.
Vi utformet overgangen slik at den var detaljstyrt og reversibel, med mulighet til å velge OCR-motor per selskap. Det ga oss fleksibilitet til å kjøre ekte produksjonstester med minimal risiko.
Vi startet med et testselskap som ble brukt av det interne teamet og interessentene. Etter hvert som tryggheten økte, aktiverte vi Document AI for en ekte kundekonto – med kundens samtykke – for å samle inn data fra virkeligheten og tidlige tilbakemeldinger.
Hvis noe så feil ut, kunne vi umiddelbart sette selskapet tilbake til ABBYY – byttet skjedde live og sømløst.
Denne utrullingen på selskapsnivå gjorde at vi kunne gå trygt videre og samtidig hele tiden validere antakelsene våre i virkeligheten.
For å holde alle samkjørte – fra utviklere til interessenter – bygget jeg et live-dashbord som viste hvordan hver OCR-leverandør presterte i sanntid.
For hver motor fulgte vi nøyaktigheten i gjenkjenningen av utlegg i prosent, basert på manuelt kontrollerte utvalg. Grensesnittet gjorde det lett å se hvilken motor som var primær, og hvordan de sto seg mot hverandre.
Vi oppdaterte statistikken jevnlig og la til og med inn en hurtigbryter, slik at vi når som helst kunne endre primær OCR-leverandør – per miljø eller selskap. Denne åpenheten hjalp alle å forstå hvorfor vi gikk over til Document AI – ikke fordi den var nyere, men fordi den beviselig var bedre.
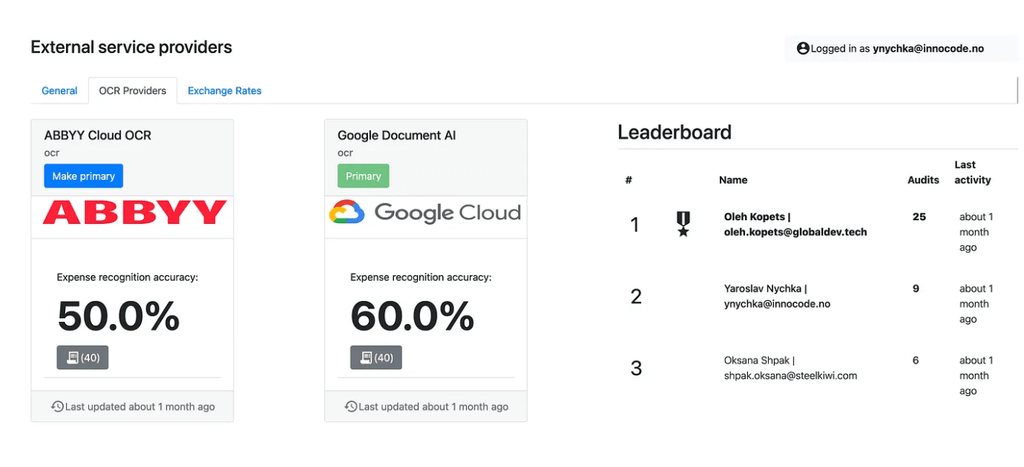
Etter uker med testing, justering og måling av nøyaktighet felt for felt talte tallene tydelig: Google Document AI presterte bedre enn ABBYY – og ikke bare litt.
Vi hadde alt på plass:
- En bryter på selskapsnivå for trygge tester.
- En reserveløsning tilbake til ABBYY i nødstilfeller.
- Data fra virkeligheten fra interne team og interessenter.
- Et live-dashbord som viste bedre gjenkjenningsnøyaktighet.
Da vi nådde målet – at Google konsekvent slo ABBYY på ekte dokumenter – nølte vi ikke.
Vi trykket på én knapp. Og vi så oss aldri tilbake.
I det øyeblikket flyttet vi alle kunder over til Google Document AI – umiddelbart og med full trygghet.
Det var mer enn et teknisk bytte. Det var et øyeblikk av frihet. Endelig hadde vi brutt lenkene til ABBYYs XML-jungel, regex-marerittene og den skjøre etterbehandlingen.
Men det øyeblikket var ikke slutten – det var en ny begynnelse.
Å erstatte ABBYY med Google Document AI var et vendepunkt, men vi var ikke ferdige.
Document AI ga oss god nøyaktighet, men de forhåndsdefinerte feltene og den begrensede fleksibiliteten klarte ikke å holde tritt med behovene våre.
De egentlige hindringene?
- Hastighet: opptil 10 sekunder per kvittering var for tregt for en god brukeropplevelse.
- Treningsarbeid: Å lære opp modellen betydde å laste opp kvitteringer, merke hvert felt og gjenta – en enorm manuell innsats.
Siden systemet vårt allerede var frikoblet fra én enkelt leverandør, gikk vi på jakt etter neste sprang. Det var da vi vendte oss mot språkmodeller som ChatGPT og Gemini – raskere, mer tilpasningsdyktige og enklere å forbedre underveis.
Mye av denne utviklingen skjedde under krigsforhold. Å holde fokus i slike tider er helt ekstraordinært – mine tanker går til kollegene våre i Ukraina. For mange var meningsfullt arbeid et pusterom fra frontens daglige grusomheter. Selv om de tilhører ulike teknologiselskaper, opplevde det ukrainske teamet vårt et felles formål – det ble helt naturlig slik under parallelle diskusjoner med flere av ECITs partnere.
Farvel til merking, hei til prompter: Slik endret Gemini alt
Da vi vurderte promptstyrte KI-alternativer, så vi på ChatGPT, men valgte til slutt Gemini av flere viktige grunner.
Som et Google-produkt ga Gemini bedre sikkerhet og regeletterlevelse ved håndtering av sensitive kundekvitteringer – et krav for å beskytte brukerdata. Prismodellen var mer kostnadseffektiv i stor skala, slik at vi kunne behandle tusenvis av kvitteringer uten å sprenge budsjettet.
Hastighet var en annen viktig faktor: Gemini svarte på bare et par sekunder, mot 9–12 sekunder med Google Document AI. Det økte kapasiteten og iterasjonstakten i løpet vårt kraftig.
Viktigst av alt lot Geminis promptbaserte tilnærming oss hoppe over tidkrevende manuell merking. Ved å skrive prompter i stedet oppnådde vi betydelig høyere gjenkjenningsnøyaktighet med mindre arbeid.
Kort sagt balanserte Gemini sikkerhet, kostnad, hastighet og nøyaktighet perfekt – og ble det åpenbare valget for systemet vårt for kvitteringsgjenkjenning.
Overgangen til Gemini gikk smidigere enn noen gang – ingen omskriving av etterbehandling, ikke noe lag med menneske i løkka.
Systemet var klart: Vi implementerte bare en ny adapter, bygget trygghet med data og trykket på bryteren.
Nå går vi enda lenger.
En lekeplass for prompter: iterer raskere, forbedre smartere
Jeg bygget et internt verktøy – en slags lekeplass for prompter – for å skrive og teste promptversjoner mot et voksende bibliotek av ekte kvitteringer, våre «gullstandarder».
Hver testkjøring ga direkte tilbakemelding: hvor godt Gemini hentet ut nøkkelfeltene.
Nå utvider vi verktøyet slik at administratorer kan laste opp hvilken som helst kvittering, eksperimentere med nye prompter og følge kvaliteten på uthentingen i sanntid.
Med KI og prompttesting i sanntid bygger vi mot en fremtid der vi kan forbedre kvitteringsgjenkjenningen fortløpende – uten utrullinger, bare rask og fleksibel utvikling drevet av smartere prompter.
Avsluttende tanker og noen personlige refleksjoner.
Da jeg kom inn i prosjektet i 2019, brukte ABBYY alt fra 30 til 120 sekunder på å behandle en kvittering – og det tok oss flere år før vi kunne ta i bruk Google Document AI og begynne å forbedre gjenkjenningskvaliteten for alvor.
Nå, med Gemini, skjer behandlingen på bare et par sekunder – en dramatisk forbedring som har forvandlet brukeropplevelsen og økt den operative effektiviteten.
Det neste store steget, slik jeg ser det, er å bygge en selvoptimaliserende motor – en som lærer av hver kvittering i sanntid, tilpasser promptene sine automatisk og forbedrer gjenkjenningen uten menneskelig inngripen. Ingen nye utrullinger. Ingen manuell finjustering. Bare et intelligent system som blir smartere for hvert dokument – og utvikler seg på egen hånd for å gi best mulig opplevelse.
Denne reisen har virkelig lært meg at moderne KI ikke bare handler om å bytte verktøy – det handler om å bygge systemer som er laget for endring. Enten du jobber med regex, klassisk OCR eller banebrytende KI, må arkitekturen være tilpasningsdyktig og klar til å utvikle seg.
Uten den fleksibiliteten kan teknisk gjeld raskt begrave selv de beste planene.
Hvis du jobber med kompleks dokumentforståelse, bør du først fokusere på å lage robuste systemer som er enkle å vedlikeholde – det riktige fundamentet åpner for ekte innovasjon og varig forretningsverdi.
Innocode (Yulieta by Innocode) har vært en stødig partner hele veien og har bidratt ikke bare med backend-utvikling, men også med QA (takk til Iryna Demkiv), arkitektur og løpende rådgivning. Jeg ser frem til mange flere år med godt samarbeid med Innocode.

Airmine
Airmine samarbeidet med Yulieta by Innocode for å skalere den tekniske kapasiteten og effektivisere utviklingen. Samarbeidet ga tilgang til kompetanse innen Flutter og React og har drevet innovasjonen innen varsling av pollenrisiko.